10 consejos para sacarle el máximo provecho a OpenCode
1. Inicializa tu proyecto con /init
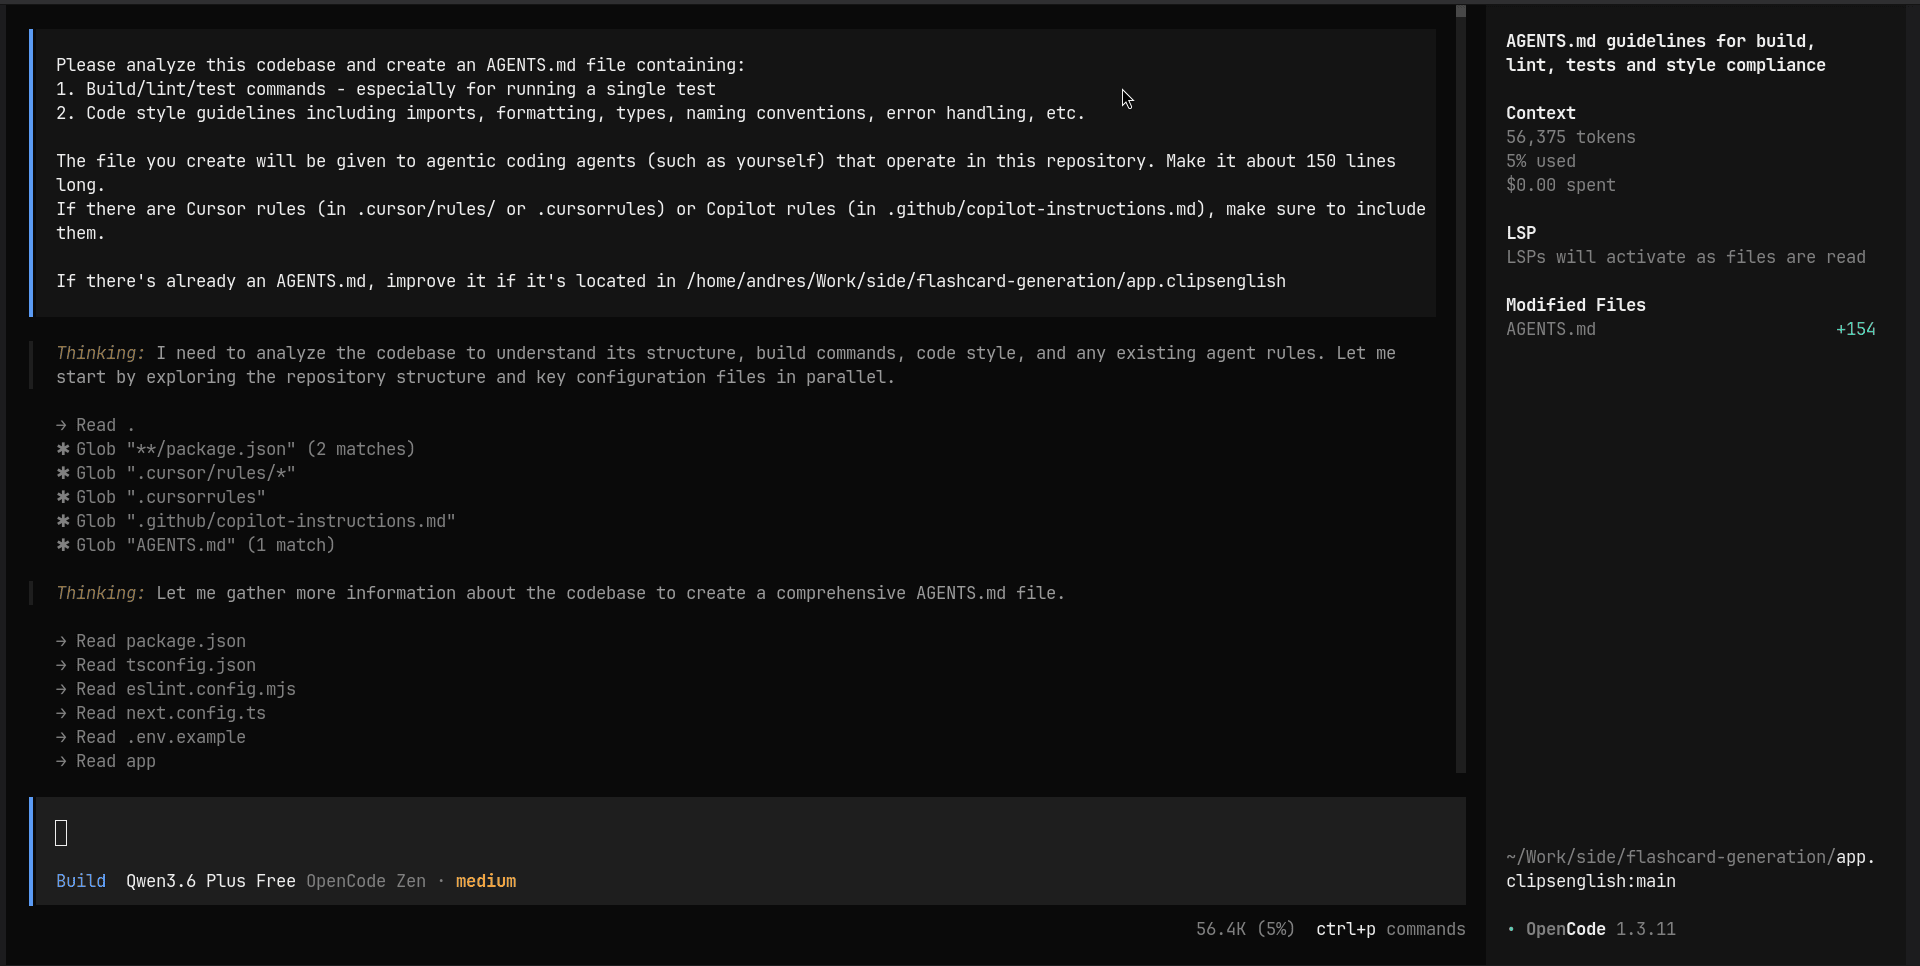
Antes de escribir una sola línea de código, ejecuta /init en la raíz de tu proyecto. OpenCode analiza tu repositorio y genera un archivo de contexto base que el modelo va a usar en cada sesión. Este es el punto de partida que te evita explicar tu proyecto desde cero en cada conversación.
Este comando crea un archivo AGENTS.md con el contexto del proyecto:
2. Usa undo y redo sin miedo
OpenCode registra los cambios que el modelo hace en tus archivos. Si un cambio no te convence, undo revierte la última acción y redo la restaura. Esto te da libertad para experimentar sin miedo a romper algo de forma permanente.
3. Menciona archivos con @ para ganar precisión
Cuando referencias un archivo con @NombreDelArchivo, el modelo sabe exactamente dónde buscar el contexto relevante en vez de escanear todo el proyecto. Eso reduce bastante el consumo de tokens y hace las respuestas mucho más precisas.
# Ejemplo
Refactoriza la lógica de autenticación en @src/features/auth/hooks/useAuth.ts
Úsalo siempre que puedas. Es uno de los hábitos que más impacto tiene en la calidad de las respuestas.
4. Cambia de modelo según la tarea
No todos los modelos cuestan lo mismo en tokens, y no toda tarea necesita el modelo más potente. Una buena regla:
- Modelo rápido/económico: exploración, preguntas simples, refactors pequeños.
- Modelo potente: arquitectura, lógica compleja, debugging profundo.
Cambiar de modelo en el momento correcto te permite hacer más con el mismo presupuesto de tokens.
Puedes visitar artificialanalysis.ai para comparar el rendimiento de los modelos.
5. Domina plan y build
OpenCode tiene dos modos de trabajo que funcionan en secuencia:
plan: el modelo analiza el problema y propone una estrategia antes de tocar código. Úsalo en tareas complejas o de riesgo alto.build: el modelo ejecuta los cambios directamente.
La combinación ideal es usar plan para validar el enfoque y después build para ejecutar. Ir directo a build en tareas complejas suele dar resultados mediocres.
6. Activa el Prompt Improver antes de programar
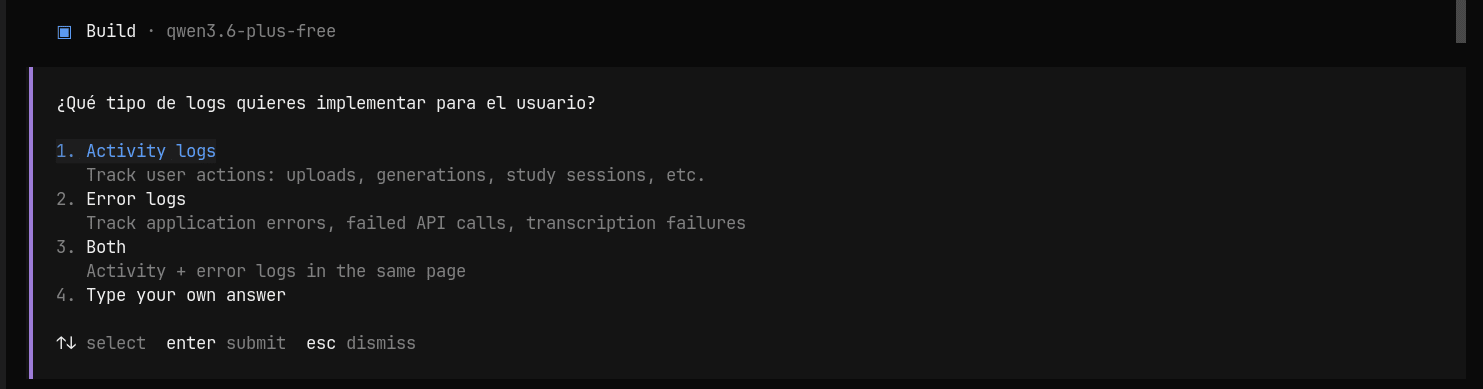
El Prompt Improver es una función que hace preguntas de aclaración antes de ejecutar una tarea. En vez de asumir lo que quieres, el modelo reúne la información que necesita para actuar con precisión. Esto te ahorra varios ciclos de corrección.
Puedes usar la skill skills.sh/github/awesome-copilot/boost-prompt para mejorar este proceso.
7. Crea comandos para tareas repetitivas
Si te descubres escribiendo el mismo tipo de instrucción una y otra vez, es señal de que necesitas un comando propio. OpenCode te deja definirlos para estandarizar tareas frecuentes como:
- Generar tests para un módulo.
- Crear una nueva feature siguiendo la estructura del proyecto.
- Revisar un archivo en busca de code smells.
Los comandos convierten una instrucción repetitiva en una sola acción.
Para configurarlos, crea una carpeta commands dentro de .opencode y añade un archivo Markdown con el nombre de tu comando (por ejemplo, .opencode/commands/NEW-FEATURE.md). Debe seguir esta estructura:
---
description: Descripción del comando
agent: plan o build
---
Contenido de la instrucción
Ejemplo detallado para un servicio:
---
description: Un comando para crear la estructura de carpetas de una nueva feature en un proyecto.
agent: build
---
Crea un nuevo servicio para la entidad $1.
Sigue el patrón de Arquitectura Hexagonal:
1. Crea el Input Port (interfaz) en `domain/ports/in`.
2. Crea la implementación del servicio en `domain/services`.
3. Usa anotaciones de Spring Boot y asegúrate de que el código sea compatible con Java 17.
4. Si se proporciona $2, úsalo como interfaz principal del repositorio.
Revisa la estructura de carpetas existente en `src/main/java` antes de generar.
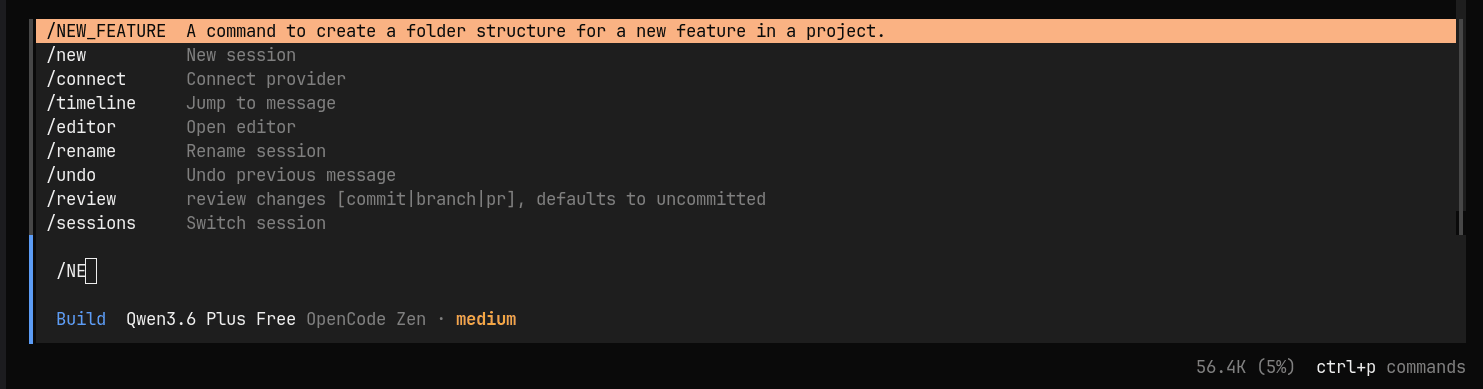
Para ejecutarlo, escribe / y OpenCode te va a sugerir tus comandos personalizados:
8. Aprovecha las skills
Las skills son fragmentos de contexto especializado que el modelo carga cuando los necesita. Antes de crear una desde cero, ejecuta find-skills para ver qué hay disponible. Puede que alguien ya haya construido justo lo que necesitas.
Puedes visitar skills.sh, donde hay muchas skills listas para usar.
9. Crea tus propias skills
Esta es la función que más diferencia hace a largo plazo. Puedes crear skills específicas del proyecto en .opencode/skills/ o en .agents/skills/ para dar compatibilidad a más agentes. Cada skill es un archivo Markdown con contexto estructurado que el modelo carga cuando hace falta.
Estructura básica:
.opencode/skills/
└── structure/
    └── SKILL.md
Una skill bien escrita define el stack, la arquitectura de carpetas y los estándares de código de tu proyecto. Por ejemplo, una skill para un proyecto de React con Feature-Sliced Design podría verse así:
---
name: structure
description: "Contexto específico del proyecto: stack, arquitectura y convenciones."
---
## Stack
- React (componentes funcionales, hooks)
- TypeScript (modo strict)
- Tailwind CSS + shadcn/ui
- TanStack Query

## Arquitectura de carpetas
- `src/components/` → Componentes genéricos y reutilizables (sin dominio).
- `src/features/<feature>/` → Módulos por dominio. Cada uno contiene:
  - `/components`, `/hooks`, `/services`, `/types`, `/store` (opcional).
- `src/services/` → Configuración global de la API (Axios, interceptores).
- `src/hooks/` → Hooks reutilizables en toda la app (`useAuth`, `useDebounce`).
- `src/lib/` → Utilidades, helpers y configuración de librerías externas.
- `src/types/` → Interfaces globales compartidas entre features.

## Estándares de código
- **Componentes tontos:** la lógica va en los hooks, no en los componentes `.tsx`.
- **Data fetching:** los servicios solo hacen el fetch. El estado asíncrono va en hooks con TanStack Query.
- **TypeScript:** prohibido usar `any`. Define interfaces explícitas para props, respuestas de la API y payloads.
- **Estilos:** usa `cn()` (clsx + tailwind-merge) para componer clases dinámicas.
- **Convenciones de nombres:**
  - Componentes: `PascalCase` → `UserProfile.tsx`
  - Hooks y utilidades: `camelCase` → `useUserFetch.ts`
  - Prefiere named exports antes que `export default`.
Con una skill así, el modelo ya sabe cómo está organizado tu proyecto, cuál es el stack y cuáles son las reglas. No tienes que repetirlo nunca más.
10. Aprovecha las sesiones continuas
OpenCode mantiene el contexto durante toda la sesión. Eso significa que puedes construir sobre lo que ya se hizo sin volver a explicar el estado del proyecto en cada mensaje. Úsalo a tu favor: en vez de abrir una sesión nueva para cada tarea, encadena tareas relacionadas. El modelo recuerda las decisiones anteriores y las aplica de forma consistente.
Puedes usar /session para listar las sesiones activas.
Frequently asked questions
¿Cómo se reduce el uso de tokens y se obtienen respuestas más precisas en OpenCode?
Ejecuta /init al inicio para generar un archivo de contexto AGENTS.md, luego, haz referencia a archivos específicos con @FileName en lugar de dejar que el modelo escanee todo el proyecto, esto reduce el consumo de tokens y mejora la precisión.
¿Cuándo debes usar el modo «plan» y cuándo el modo «build» en OpenCode?
Usa el modo plan para tareas complejas o de alto riesgo, de modo que el modelo proponga una estrategia antes de tocar el código, luego, cambia al modo build para ejecutarla. Saltar directamente al modo build en tareas complejas suele producir peores resultados.
¿Cómo se crean habilidades personalizadas en OpenCode para la programación de IA específica de un proyecto?
Agrega un archivo SKILL.md dentro de .opencode/skills/ (o .agents/skills/) en el que definas tu pila tecnológica, la arquitectura de carpetas y los estándares de código, para que el modelo siga automáticamente las convenciones de tu proyecto sin que tengas que volver a explicarlas en cada sesión.
Comments