Cómo instalar Ollama y Gemma 3B en Linux
Piénsalo como un asistente personal para la IA que te permite:
- Descargar modelos: Ollama te deja buscar y descargar modelos preentrenados en poco tiempo.
- Probar sin complicaciones: te ahorra montar entornos de desarrollo complicados.
1. Instalar Ollama
Ejecuta este comando en tu terminal:
curl -fsSL https://ollama.com/install.sh | shEntra en la web oficial de Ollama para más información o para instalarlo en otro sistema operativo: https://ollama.com/download
2. Instalar un modelo en Ollama
Ollama tiene una biblioteca donde puedes ver los modelos disponibles en https://ollama.com/search. En este ejemplo voy a instalar Gemma 3, un modelo capaz de correr incluso con una sola CPU.
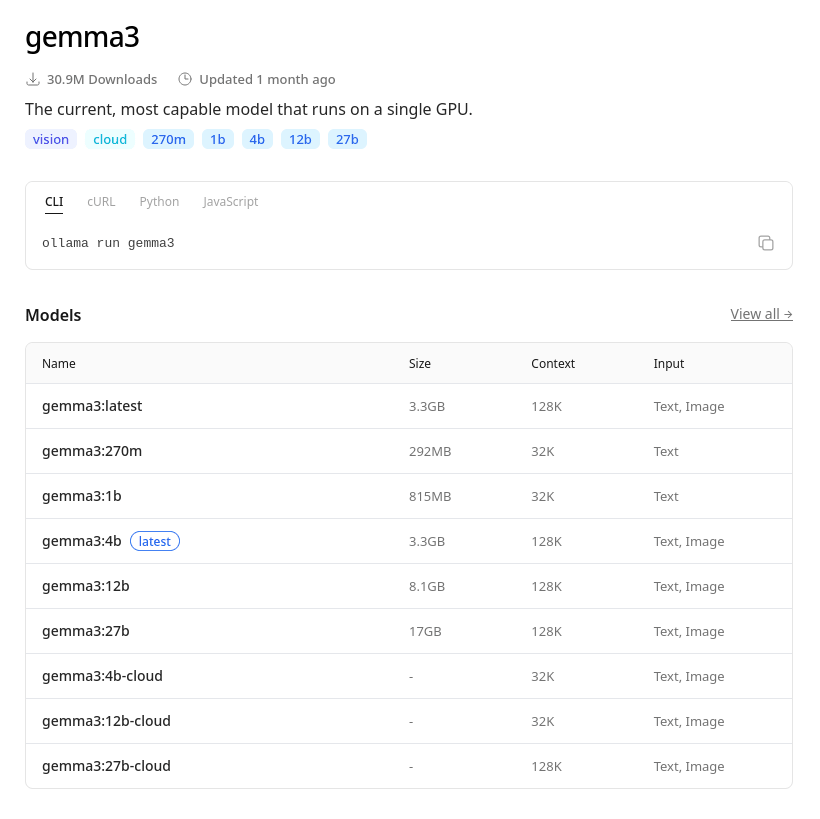
Ejecuta el siguiente comando en tu terminal:
ollama run gemma3:1bEl texto después de los dos puntos (":") indica la versión exacta, porque un mismo modelo puede tener variantes según el tamaño, la ventana de contexto, los tipos de entrada que soporta, etc.
¿Por qué usar la versión 1B?
Sobre todo por dos razones:
- Usa poca RAM: solo necesita entre 1,5 GB y 2 GB.
- Velocidad instantánea: es ideal para tareas donde la respuesta tiene que ser inmediata.
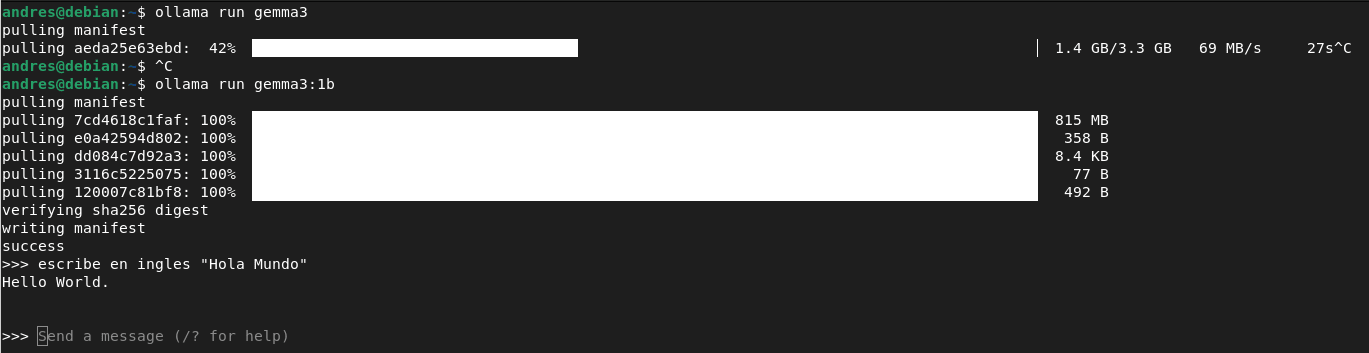
3. Escribe tu prompt
Escribe tu prompt y la terminal de Ollama mostrará el texto generado.
Enlaces
- Ollama: https://ollama.com/
- Gemma 3: https://deepmind.google/models/gemma/gemma-3/
- Documentación de Ollama: https://docs.ollama.app/
Frequently asked questions
¿Cómo se instala Ollama y se ejecuta un modelo de IA local?
Instala Ollama con curl -fsSL https://ollama.com/install.sh | sh, luego ejecuta un modelo con un comando como ollama run gemma3:1b, sin necesidad de configurar un entorno de desarrollo complicado.
¿Por qué usar la versión de 1B de Gemma 3 en lugar de un modelo más grande?
La versión de 1B solo necesita entre 1.5 y 2 GB de RAM y responde casi al instante, lo que la hace ideal para tareas ligeras en las que la velocidad es más importante que la capacidad máxima, e incluso puede ejecutarse en una sola CPU.
¿Dónde puedes encontrar y descargar modelos de IA para Ollama?
Explora la biblioteca de modelos de Ollama en ollama.com/search y, a continuación, obtén una versión específica utilizando ollama run modelname:tag, donde la etiqueta después de los dos puntos especifica el tamaño, la ventana de contexto y otras variaciones.
Comments