Spring MVC vs WebFlux: a dónde van realmente tus hilos
Spring MVC le da un hilo a cada petición. Eso funciona bien con poco tráfico. Deja de funcionar cuando mil usuarios golpean tu API al mismo tiempo.
Un hilo, de principio a fin
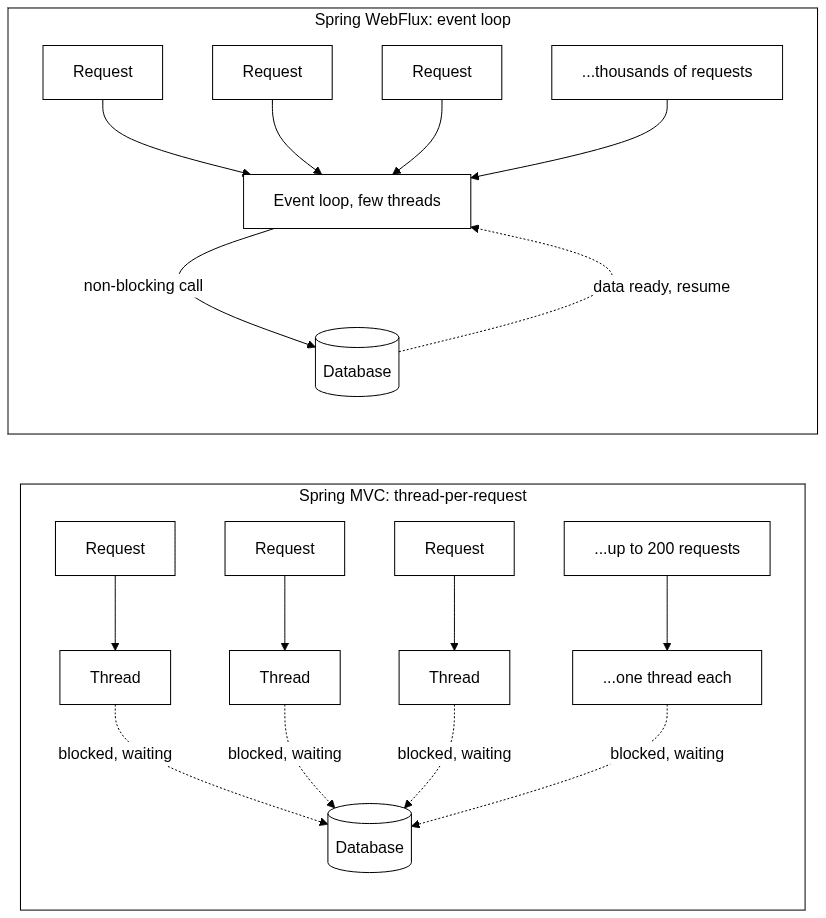
En Spring MVC, cada petición HTTP recibe un hilo del thread pool del contenedor de servlets. A esto se le conoce como el modelo thread-per-request.
Ese hilo se mantiene ocupado durante toda la petición. Controlador, servicio, repositorio, base de datos, respuesta. No vuelve al pool hasta que la petición termina.
@GetMapping("/users/{id}")
public User getUser(@PathVariable Long id) {
    return userService.findById(id); // el hilo espera aquí hasta que todo termine
}
Más usuarios significa más hilos
Más peticiones concurrentes significa más hilos. Pero los hilos no son gratis.
Cada hilo consume RAM. Y la CPU gasta tiempo en el context switching, decidiendo qué hilo ejecutar después. Si agregas demasiados hilos, el sistema termina gastando más tiempo cambiando entre ellos que haciendo trabajo real.
El costo real es esperar, no trabajar
La mayor parte del tiempo de un hilo en este modelo no se gasta calculando. Se gasta esperando: una consulta a la base de datos, una llamada a una API externa.
Digamos que una consulta tarda 4 segundos. Ese hilo queda bloqueado esos 4 segundos, sin hacer nada, solo ocupando un espacio en el pool.
WebFlux: menos hilos, ninguno esperando
Spring WebFlux, basado en Project Reactor y que se ejecuta en Netty de forma predeterminada, reemplaza el thread-per-request con un event loop. Un número pequeño de hilos se encarga de todo.
Cuando un hilo necesita hacer I/O, como una llamada a la base de datos, envía la petición y regresa de inmediato. No espera la respuesta. El sistema operativo le avisa al event loop cuando los datos están listos (en Linux, esto usa epoll), y el hilo retoma la tarea justo donde la dejó.
Un solo hilo puede manejar miles de peticiones en curso sin bloquearse en ninguna en particular.
@GetMapping("/users/{id}")
public Mono<User> getUser(@PathVariable Long id) {
    return userService.findById(id); // devuelve el resultado de inmediato, el hilo pasa a realizar otra tarea
}
La misma forma, el mismo nombre de método. El tipo que se retorna es lo que lo cambia todo.
Esto se me hizo familiar. Si has trabajado con JavaScript, en el navegador o en Node, ya conoces este patrón: un hilo, I/O no bloqueante, y un callback (o una promesa) que retoma la ejecución cuando los datos están listos. Es la misma idea. La diferencia está en la escala. JavaScript corre sobre un solo hilo de event loop. WebFlux corre varios, usualmente uno por núcleo de CPU, así que es más parecido a tener varios event loops pequeños al estilo Node trabajando en paralelo, en vez de uno solo.
Backpressure: el cliente marca el ritmo
WebFlux también cambia cómo transmites datos. En vez de enviar toda la respuesta de una vez, el servidor abre un canal y empuja pequeños fragmentos a medida que están listos.
El cliente puede indicarle al servidor cuántos datos quiere recibir a la vez. A esto se le llama backpressure. Es útil para todo lo que sigue generando datos después de la primera respuesta: feeds de bolsa en tiempo real, actualizaciones de ubicación en tiempo real, ese tipo de flujo.
El truco: toda la cadena tiene que ser no bloqueante
La mayoría de las introducciones a WebFlux se saltan esta parte. Solo vale la pena si todo tu stack es no bloqueante.
Tu driver de base de datos tiene que ser reactivo: R2DBC, no JDBC. Tu cliente HTTP tiene que ser WebClient, no RestTemplate. El tipo de retorno lo delata:
// JDBC: bloqueante, retorna el valor directamente
public User findById(Long id) {
    return jdbcTemplate.queryForObject(SQL, mapper, id);
}

// R2DBC: no bloqueante, retorna un tipo reactivo
public Mono<User> findById(Long id) {
    return databaseClient.sql(SQL)
        .bind("id", id)
        .map(mapper)
        .one();
}
Si usas WebFlux pero mantienes una sola llamada bloqueante a JDBC, bloqueas uno de los pocos hilos del event loop, normalmente tantos como núcleos tiene tu CPU. En MVC, perder un hilo de doscientos (el tamaño por defecto del pool de Tomcat en Spring Boot) casi no se nota. En WebFlux, perder uno de esos pocos es un problema mucho más grande.
Antes de migrar, revisa cada capa en busca de una llamada bloqueante. Basta con una sola para anular el beneficio.
Frequently asked questions
¿Cuál es la diferencia principal entre Spring MVC y Spring WebFlux?
Spring MVC le da un hilo a cada petición y bloquea ese hilo hasta que la petición termina. Spring WebFlux usa un pool pequeño de hilos en un event loop no bloqueante, así que un solo hilo puede manejar muchas peticiones a la vez.
¿Spring WebFlux siempre es más rápido que Spring MVC?
No. WebFlux ayuda más bajo alta concurrencia con trabajo pesado en I/O, como consultas lentas o llamadas a APIs externas. Con poco tráfico o trabajo pesado en CPU, MVC suele rendir igual de bien y es más simple de razonar.
¿Puedo usar WebFlux con un driver JDBC normal?
Puedes, pero pierde el sentido. Una llamada bloqueante a JDBC dentro de WebFlux ocupa uno de los pocos hilos del event loop, lo cual duele más que bloquear un hilo en un pool de 200 en MVC. Usa un driver reactivo como R2DBC en su lugar.
¿Qué es el backpressure en Spring WebFlux?
Backpressure es la capacidad del cliente de decirle al servidor cuántos datos puede manejar a la vez, en vez de que el servidor empuje todo de una sola vez. Viene de la especificación Reactive Streams que WebFlux implementa.
¿Necesito reescribir toda mi aplicación para usar WebFlux?
Sí, si quieres el beneficio real. Controladores, servicios, repositorios y clientes HTTP necesitan tipos reactivos (Mono, Flux) de principio a fin. Mezclar código bloqueante y reactivo en la misma petición es un error común y costoso.
Comments